
Recordaremos la semana del 10 al 16 de marzo de 2026 como la de los humanoides: una sala de entrenamiento gigante en Múnich, una presentación principal de NVIDIA en GTC, un plan quinquenal chino, un robot-títere en el escenario, una proyección de tres mil millones de máquinas en 2060. Seis anuncios, seis protagonistas, y la tentación de clasificarlos en bandos: Europa contra China, el código abierto contra el propietario. Es pasar por alto la única frase que los une, y es NEURA Robotics quien la ha escrito en blanco y negro: el principal cuello de botella de la robótica ya no es el hardware, es la adquisición de grandes cantidades de datos de aprendizaje físico reales.
Una vez establecida esta frase, la semana deja de ser una yuxtaposición. Se convierte en una batalla —con tres respuestas incompatibles— en torno a una sola pregunta: ¿de dónde vienen los datos que entrenan a los robots? Recogerlos a mano, sintetizarlos mediante el cálculo, o decretarlos por el Estado. Nadie ha ganado. Nos hemos peleado por saber quién posee la fábrica.
Respuesta n.º 1: recogerlos a mano
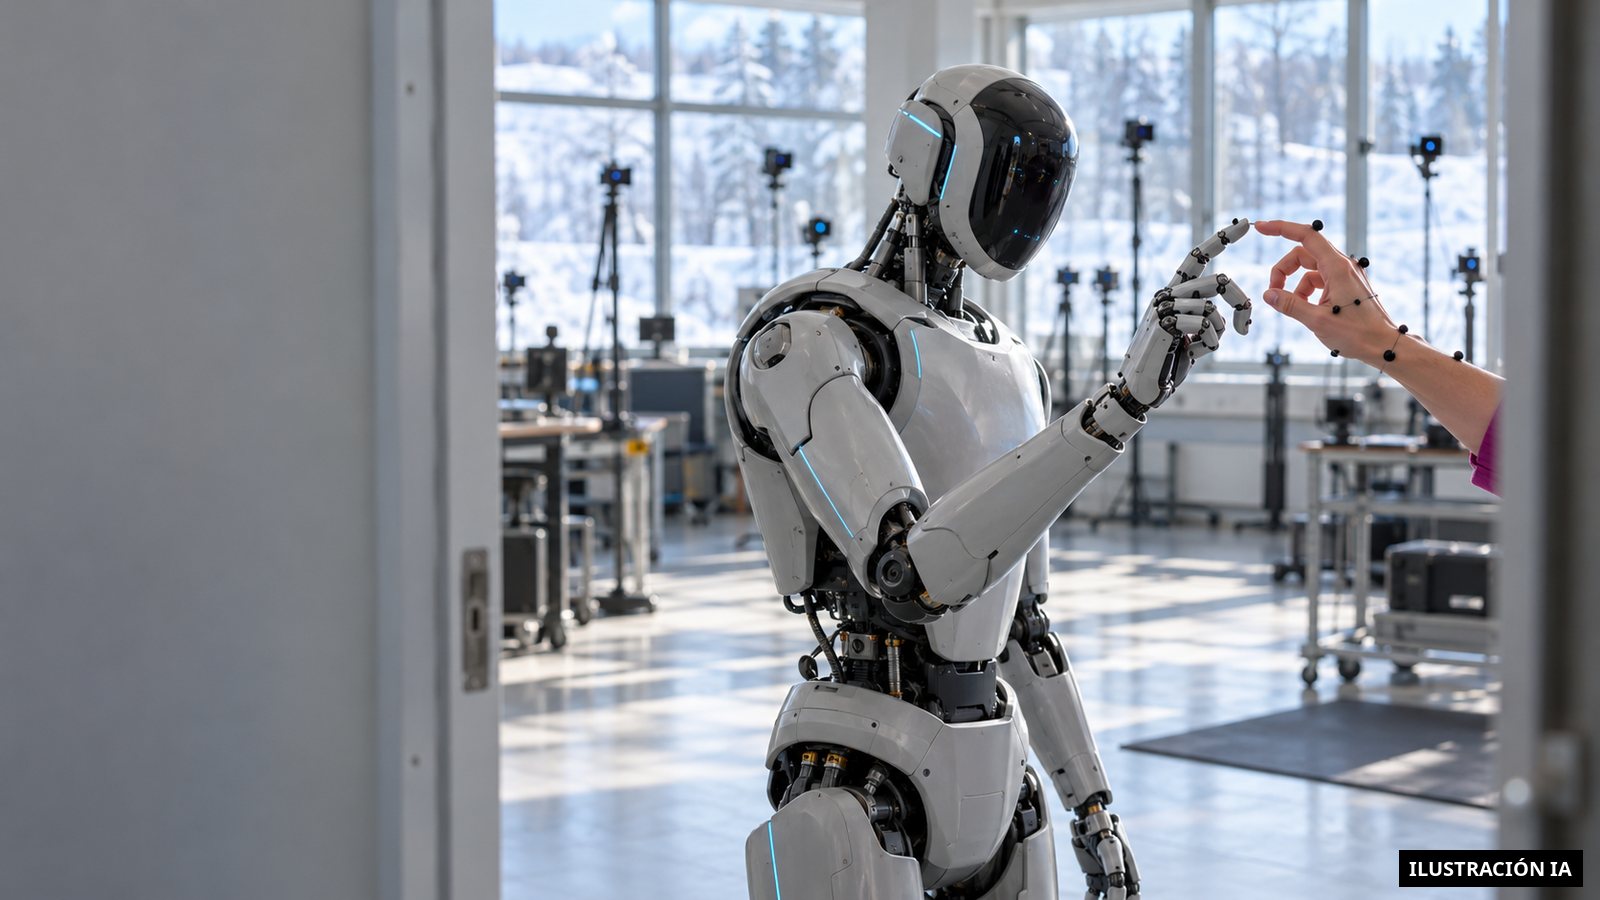
El 10 de marzo, NEURA Robotics y el MIRMI de la Technische Universität München anuncian conjuntamente el TUM RoboGym. La presentación es sin rodeos: el mayor centro científico de Europa dedicado al entrenamiento de Physical AI en el momento de su anuncio. Pero el dispositivo interior dice mejor que los superlativos de qué se trata. Los datos de aprendizaje se capturan allí mediante formadores humanos que llevan guantes MANUS y un sistema de captura de movimiento corporal Xsens, y luego se inyectan en la plataforma Neuraverse.
Es la confesión literal del cuello de botella: se paga a humanos para fabricar a mano la materia prima que falta. Neuraverse está diseñado además como un sistema de recopilación y distribución agnóstico al hardware, destinado a abrirse a socios industriales y startups, y la mayoría de los datos generados en el RoboGym se compartirán en código abierto con la comunidad robótica. El gesto humano, capturado y redistribuido, como recurso. Los datos no son un subproducto del entrenamiento: son el producto, y se necesita un pabellón de 17 millones de euros para producirlos.
Respuesta n.º 2: sintetizarlos mediante el cálculo
En GTC 2026, el 16 de marzo, NVIDIA realiza la operación exactamente inversa —y lo asume. Jensen Huang presenta en exclusiva GR00T N2, un modelo de fundación robótico derivado de la investigación interna DreamZero, dotado de una arquitectura «world action model», cuya disponibilidad general se anuncia para finales de 2026. Según NVIDIA, los robots que lo ejecutan completan tareas nuevas en entornos desconocidos más del doble de veces que los modelos de visión-lenguaje-acción competidores.
Alrededor del modelo, toda una cadena de síntesis: el Physical AI Data Factory Blueprint, una arquitectura de referencia abierta para generar datos de entrenamiento a gran escala, construida sobre el modelo de mundo Cosmos y el orquestador OSMO; Isaac Lab 3.0 en acceso anticipado, un motor de aprendizaje por refuerzo basado en el motor físico Newton 1.0 y optimizado para las infraestructuras DGX. The Decoder resume la maniobra sin contemplaciones: NVIDIA quiere «transformar el problema de datos de la robótica en un problema de cálculo».
La demostración que lo condensa todo es Olaf. Para entrenar este robot, se simuló simultáneamente 100 000 instancias virtuales en dos días sobre una única GPU NVIDIA RTX 4090, a través del simulador Kamino —una herramienta propietaria de Disney Research, construida sobre el solver Newton y acelerada por tarjeta gráfica. Ahí está el dato duro, exhumado bajo el folklore de los tres mil millones de humanoides: no un horizonte para 2060, sino 100 000 instancias en dos días sobre una tarjeta de consumo. El día en que entrenar un robot deje de ser un problema de brazos y guantes para convertirse en un problema de tarjetas gráficas, el centro de gravedad de la industria abandona el taller para ir al centro de datos. Y la consecuencia es clara: si los datos se convierten en cálculo, quien vende el cálculo posee los datos por defecto.
Respuesta n.º 3: decretarlos
El 12 de marzo, la Asamblea Popular Nacional adopta formalmente el 15.º Plan Quinquenal chino (2026-2030). Por primera vez, la inteligencia artificial encarnada se clasifica en él como categoría industrial estratégica autónoma, al mismo nivel que la computación cuántica, las interfaces cerebro-máquina y la 6G; los robots humanoides figuran entre las ocho industrias estratégicas nacionales designadas, una elevación de estatus respecto al 14.º plan.
El detalle que importa aquí no es la ambición general, sino la lista. El plan enumera cinco ejes para la IA encarnada, y dos de ellos nombran precisamente a los datos como infraestructura estatal: la coordinación de los campos de entrenamiento y la fusión virtual-real para el entrenamiento colaborativo —es decir, las dos primeras respuestas, recogida y síntesis, planificadas desde arriba. Todo respaldado por un fondo estatal de capital riesgo de 1 000 mil millones de yuanes (aproximadamente 138 mil millones de dólares) dedicado a la IA, la robótica y las tecnologías emergentes.
Y para que los datos existan, hacen falta cuerpos que los produzcan. En marzo, UBTech Robotics firma un acuerdo de cooperación estratégica con Siemens Digital Industries Software para llevar la producción del Walker S2 a 10 000 unidades al año, integrando los software de Siemens de diseño, simulación y planificación en todo el ciclo de fabricación. Fabricar en masa las máquinas que, una vez desplegadas, generarán a su vez los datos: el círculo se cierra a escala de un Estado.
La «bifurcación geopolítica» no se sostiene
El relato fácil de la semana era el de una fractura: un contrapeso europeo —el RoboGym se posiciona explícitamente frente a los cuarenta centros de recopilación chinos y a las iniciativas estadounidenses— contra bloques rivales. El gráfico de la semana desmonta este relato.
La única autonomía real demostrada, sin teleoperador, es en GTC: RealSense y LimX Dynamics realizan la primera demostración mundial de navegación autónoma 3D para humanoides, combinando cámaras de profundidad RealSense y cuVSLAM de NVIDIA, con el robot moviéndose en espacios compartidos con humanos sin la menor intervención de un operador. Sin embargo, este robot es chino —LimX tiene su sede en Shenzhen— y fue entrenado mediante aprendizaje por refuerzo en NVIDIA Isaac Lab para reducir la brecha sim-to-real.
La misma semana, NEURA (Europa), Figure AI (Estados Unidos), Agility Robotics (Estados Unidos) y AgiBot (China) anuncian todos la adopción de los modelos Isaac GR00T N, mientras NVIDIA confía el motor Newton a la Linux Foundation y lo publica en código abierto bajo licencia Apache 2.0, co-desarrollado con Disney Research y Google DeepMind. Los «bandos» quizás se disputen los datos por la geografía. Pero los entrenan todos en el mismo simulador, con el mismo modelo de fundación, sobre el mismo motor físico. La fractura está en la recopilación, no en la herramienta: a nivel de la pila, no hay dos bloques, hay un proveedor.
Un nivel más abajo
Este hilo desciende por la pila capa por capa, semana a semana. En diciembre, la demo era el producto; en el CES de enero, la teleoperación se convertía en un negocio de datos; en febrero, el cuerpo se revelaba consumible, el valor residía en el cerebro; el 9 de marzo, la pregunta era: ¿quién posee el cerebro? Esta semana desciende un paso más, bajo el cerebro: ¿quién posee la fábrica de datos que lo alimenta? El objeto es nuevo —los datos de entrenamiento y su modo de producción— y está atestiguado la misma semana por un centro físico (el RoboGym), una pila de síntesis (la Data Factory y Olaf) y un plan estatal (el 15.º Plan).
Entonces, no pregunten qué robot ha caminado mejor esta semana. Pregunten de dónde vienen sus datos de entrenamiento. Las tres respuestas —recogerlos a mano, simularlos, decretarlos— dibujan el verdadero mapa de fuerzas. Y mientras los tres se afanan, NVIDIA trabaja para que solo quede una pregunta por hacer: ¿cuántas GPU?