
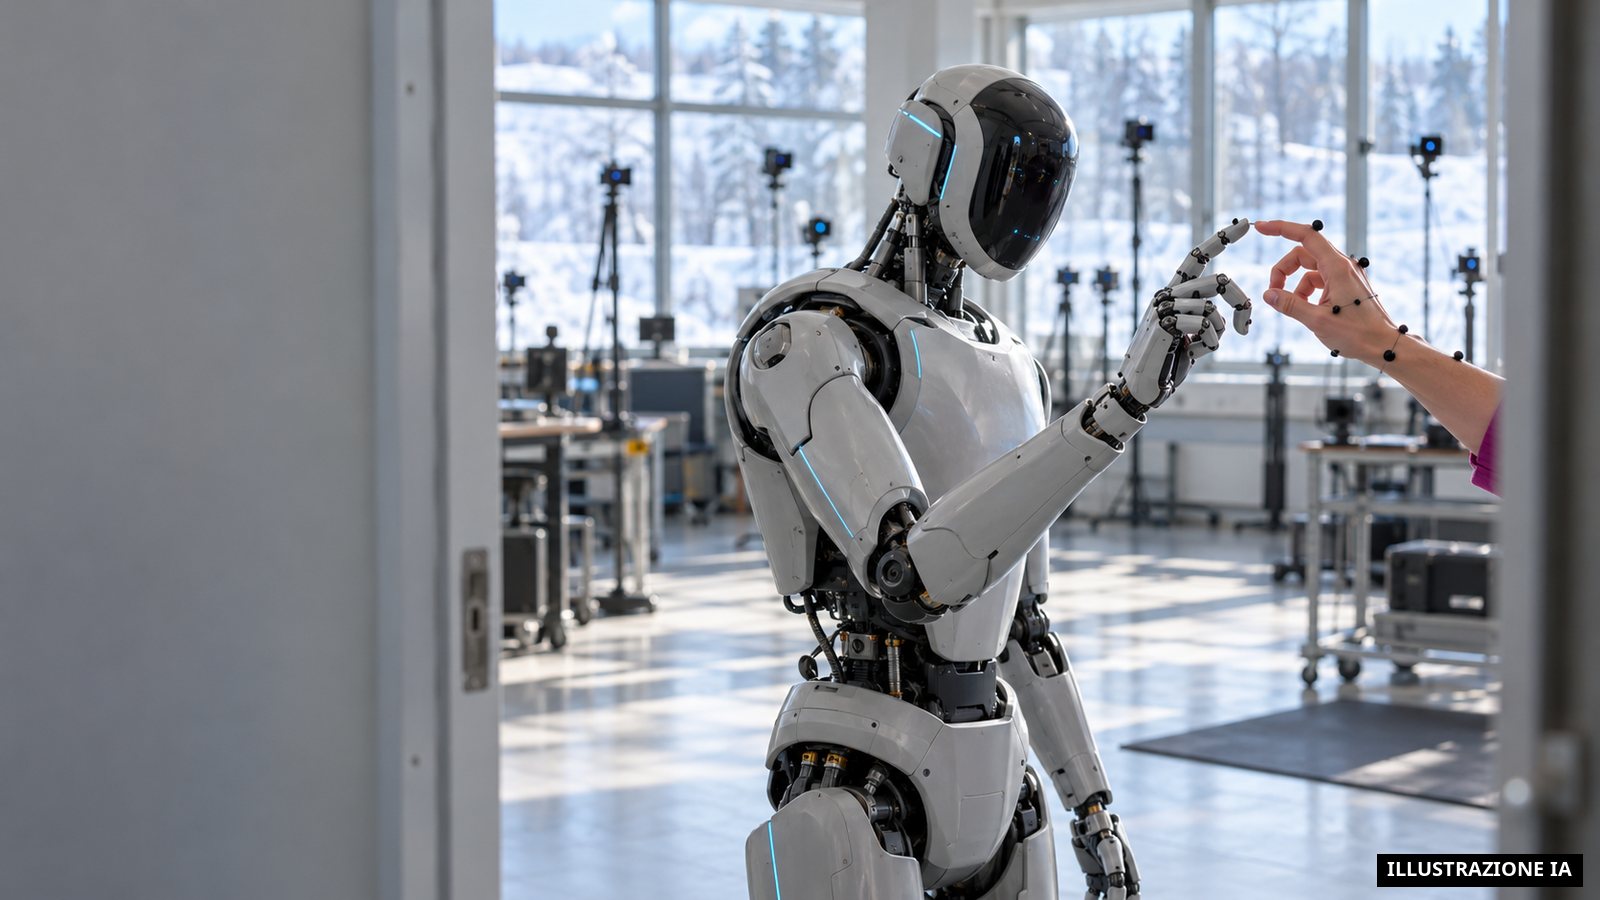
Ricorderemo la settimana dal 10 al 16 marzo 2026 come quella degli umanoidi: una sala di addestramento gigante a Monaco, un keynote NVIDIA al GTC, un piano quinquennale cinese, un robot-marionetta sul palco, una proiezione di tre miliardi di macchine nel 2060. Sei annunci, sei protagonisti, e la tentazione di raggrupparli in campi — l’Europa contro la Cina, l’open source contro il proprietario. È perdere di vista l’unica frase che li collega, ed è NEURA Robotics a scriverla nero su bianco: il principale collo di bottiglia della robotica non è più l’hardware, è l’acquisizione di grandi quantità di dati di apprendimento fisico reali.
Una volta posta questa frase, la settimana smette di essere una giustapposizione. Diventa una battaglia — con tre risposte incompatibili — attorno a una sola domanda: da dove viene il dato che addestra i robot? Raccoglierlo a mano, sintetizzarlo tramite calcolo, o decretarlo tramite lo Stato. Nessuno ha vinto. Ci si è battuti per sapere chi detiene la fabbrica.
Risposta n°1: raccoglierlo a mano
Il 10 marzo, NEURA Robotics e il MIRMI della Technische Universität München annunciano congiuntamente il TUM RoboGym. La presentazione è senza giri di parole: il più grande centro scientifico d’Europa dedicato all’addestramento della Physical AI al momento dell’annuncio. Ma il dispositivo interno dice meglio dei superlativi di cosa si tratta. Il dato di apprendimento vi è catturato da formatori umani che indossano guanti MANUS e un sistema di motion capture corporea Xsens, poi iniettato nella piattaforma Neuraverse.
È l’ammissione letterale del collo di bottiglia: si pagano degli umani per produrre a mano la materia prima che manca. Neuraverse è inoltre concepito come un sistema hardware-agnostico di raccolta e distribuzione, destinato ad aprirsi ai partner industriali e alle startup, e la maggior parte dei dati generati al RoboGym sarà condivisa in open source con la comunità robotica. Il gesto umano, catturato e ridistribuito, come risorsa. Il dato non è un sottoprodotto dell’addestramento: è il prodotto, e serve un palazzetto da 17 milioni di euro per produrlo.
Risposta n°2: sintetizzarlo tramite calcolo
Al GTC 2026, il 16 marzo, NVIDIA fa l’operazione esattamente opposta — e lo assume. Jensen Huang rivela in anteprima GR00T N2, modello di fondazione robotico derivato dalla ricerca interna DreamZero, dotato di un’architettura « world action model », la cui disponibilità generale è annunciata per la fine del 2026. Secondo NVIDIA, i robot che lo eseguono riescono in nuovi compiti in ambienti sconosciuti più di due volte più spesso rispetto ai modelli vision-language-action concorrenti.
Athorno del modello, un’intera catena di sintesi: il Physical AI Data Factory Blueprint, architettura di riferimento aperta per generare dati di addestramento su larga scala, costruita sul modello di mondo Cosmos e sull’orchestratore OSMO; Isaac Lab 3.0 in accesso anticipato, motore di reinforcement learning basato sul motore fisico Newton 1.0 e ottimizzato per le infrastrutture DGX. The Decoder riassume la mossa senza mezzi termini: NVIDIA vuole « trasformare il problema del dato nella robotica in un problema di calcolo ».
La dimostrazione che condensa tutto è Olaf. Per addestrare questo robot, 100 000 istanze virtuali sono state simulate simultaneamente in due giorni su un’unica GPU NVIDIA RTX 4090, tramite il simulatore Kamino — strumento proprietario di Disney Research, costruito sul solver Newton e accelerato da scheda grafica. Ecco il numero duro, riportato alla luce sotto il folklore dei tre miliardi di umanoidi: non un orizzonte al 2060, ma 100 000 istanze in due giorni su una scheda consumer. Il giorno in cui addestrare un robot smette di essere un problema di braccia e guanti per diventare un problema di schede grafiche, il centro di gravità dell’industria lascia l’officina per il datacenter. E la conseguenza è limpida: se il dato diventa calcolo, chi vende il calcolo possiede il dato di default.
Risposta n°3: decretarlo
Il 12 marzo, l’Assemblea nazionale popolare adotta formalmente il 15° Piano quinquennale cinese (2026-2030). Per la prima volta, l’intelligenza artificiale incarnata vi è classificata come categoria industriale strategica autonoma, allo stesso livello del quantistico, delle interfacce cervello-macchina e della 6G; i robot umanoidi figurano tra le otto industrie strategiche nazionali designate, un’elevarsi di status rispetto al 14° piano.
Il dettaglio che conta qui non è l’ambizione generale, ma l’elenco. Il piano elenca cinque assi per l’IA incarnata, e due di essi nominano precisamente il dato come infrastruttura statale: la coordinazione dei campi di addestramento e la fusione virtuale-reale per l’addestramento collaborativo — cioè le prime due risposte, raccolta e sintesi, pianificate dall’alto. Il tutto supportato da un fondo di venture capital statale da 1 000 miliardi di yuan (circa 138 miliardi di dollari) dedicato all’IA, alla robotica e alle tecnologie emergenti.
E perché il dato esista, servono corpi che lo producano. A marzo, UBTech Robotics firma un accordo di cooperazione strategica con Siemens Digital Industries Software per portare la produzione del Walker S2 a 10 000 unità all’anno, integrando i software Siemens di progettazione, simulazione e pianificazione in tutto il ciclo di fabbricazione. Produrre in massa le macchine che, una volta distribuite, genereranno a loro volta il dato: il cerchio si chiude alla scala di uno Stato.
La « biforcazione geopolitica » non regge
Il racconto facile della settimana era quello di una frattura: un contrappeso europeo — il RoboGym si posiziona d’altronde esplicitamente contro i quaranta centri di raccolta cinesi e le iniziative americane — contro blocchi rivali. Il grafico della settimana smonta questo racconto.
L’unica autonomia reale dimostrata, senza teleoperatore, è al GTC: RealSense e LimX Dynamics realizzano la prima dimostrazione mondiale di navigazione autonoma 3D per umanoide, combinando telecamere di profondità RealSense e cuVSLAM di NVIDIA, il robot si muove in spazi condivisi con gli umani senza il minimo intervento di un operatore. Eppure questo robot è cinese — LimX ha sede a Shenzhen — ed è stato addestrato tramite reinforcement learning in NVIDIA Isaac Lab per ridurre il gap sim-to-real.
Nella stessa settimana, NEURA (Europa), Figure AI (Stati Uniti), Agility Robotics (Stati Uniti) e AgiBot (Cina) annunciano tutti l’adozione dei modelli Isaac GR00T N — mentre NVIDIA affida il motore Newton alla Linux Foundation e lo pubblica in open source con licenza Apache 2.0, co-sviluppato con Disney Research e Google DeepMind. I « campi » forse si contendono il dato per geografia. Ma lo addestrano tutti sullo stesso simulatore, con lo stesso modello di fondazione, sullo stesso motore fisico. La frattura è nella raccolta, non nello strumento: a livello dello stack, non ci sono due blocchi, c’è un fornitore.
Un livello più in basso
Questo filo scende lo stack strato per strato, settimana dopo settimana. A dicembre, la demo era il prodotto; al CES di gennaio, la teleoperazione diventava un business di dati; a febbraio, il corpo si rivelava consumabile, il valore risiedeva nel cervello; il 9 marzo, la domanda era: chi possiede il cervello? Questa settimana scende di un ulteriore gradino, sotto il cervello: chi possiede la fabbrica di dati che lo nutre? L’oggetto è nuovo — il dato di addestramento e il suo modo di produzione — ed è attestato nella stessa settimana da un centro fisico (il RoboGym), uno stack di sintesi (la Data Factory e Olaf) e un piano statale (il 15° Piano).
Allora non chiedete quale robot ha camminato meglio questa settimana. Chiedete da dove viene il suo dato di addestramento. Le tre risposte — raccoglierlo a mano, simularlo, decretarlo — disegnano la vera mappa delle forze. E mentre i tre si affannano, NVIDIA lavora affinché non resti più che una sola domanda da fare: quanti GPU?