
We zullen de week van 10 tot 16 maart 2026 onthouden als de week van de humanoïden: een enorme trainingshal in München, een NVIDIA-keynote op GTC, een Chinees vijfjarenplan, een poppuppet-robot op het podium, een projectie van drie miljard machines in 2060. Zes aankondigingen, zes kopstukken, en de verleiding om ze in kampen te verdelen — Europa tegen China, open source tegen proprietary. Dat is de enige zin die ze verbindt missen, en dat is NEURA Robotics die het zwart op wit heeft geschreven: het belangrijkste knelpunt in de robotica is niet langer de hardware, maar de acquisitie van grote hoeveelheden echte fysieke leergespreksdata.
Zodra deze zin is neergelegd, stopt de week met het zijn van een juxtapositie. Het wordt een strijd — met drie incompatibele antwoorden — rond één enkele vraag: waar komt de data vandaan die robots traint? Het handmatig verzamelen, het synthetiseren via berekening, of het decreteren door de staat. Niemand heeft gewonnen. We hebben gestreden om te weten wie de fabriek bezit.
Antwoord nr. 1: het handmatig verzamelen
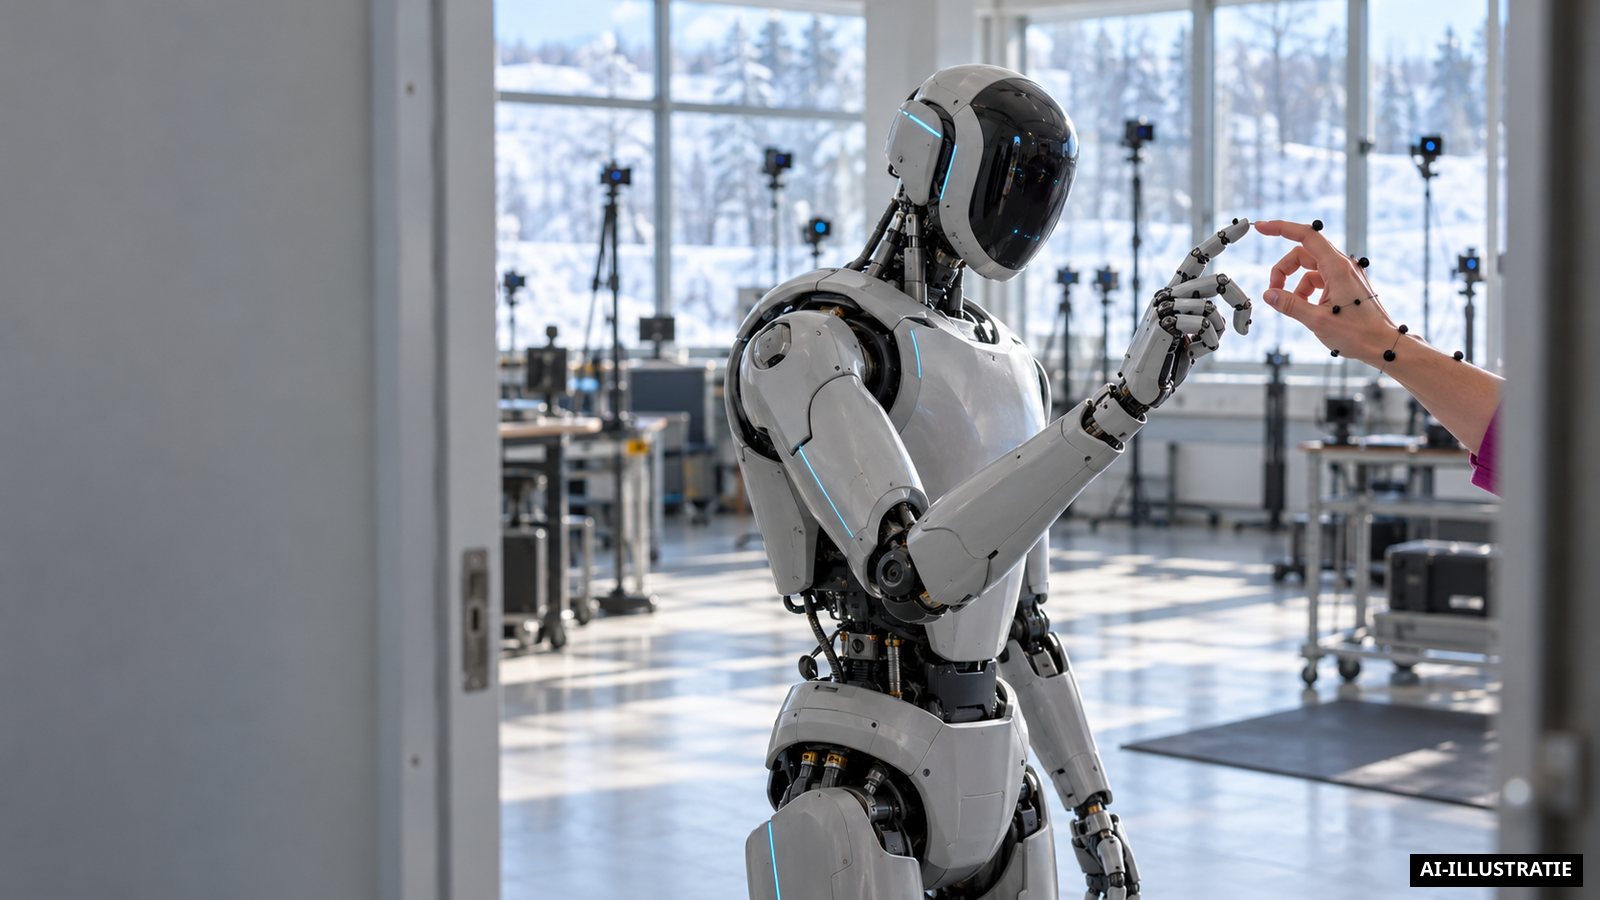
Op 10 maart kondigen NEURA Robotics en het MIRMI van de Technische Universität München gezamenlijk de TUM RoboGym aan. De presentatie is zonder omwegen: het grootste wetenschappelijke centrum van Europa gewijd aan het trainen van Physical AI op het moment van de aankondiging. Maar de interne opstelling zegt beter dan superlatieven waar het over gaat. De leergespreksdata wordt daar gevangen door menselijke trainers die MANUS handschoenen en een Xsens body motion capture-systeem dragen, en vervolgens wordt deze geïnjecteerd in de Neuraverse-platform.
Het is de letterlijke toekenning van het knelpunt: we betalen mensen om de ontbrekende grondstof handmatig te produceren. Neuraverse is overigens ontworpen als een hardware-agnostisch systeem voor verzameling en distributie, bedoeld om open te staan voor industriële partners en startups, en de meerderheid van de data die in de RoboGym wordt gegenereerd, zal open source worden gedeeld met de robotica-gemeenschap. Het menselijke gebaar, gevangen en herverdeeld, als resource. De data is geen bijproduct van de training: het is het product, en je hebt een hal van 17 miljoen euro nodig om het te produceren.
Antwoord nr. 2: het synthetiseren via berekening
Op GTC 2026, op 16 maart, doet NVIDIA precies het tegenovergestelde — en erkent dat. Jensen Huang onthult in première GR00T N2, een robotica-fundatiemodel afkomstig uit het interne onderzoek DreamZero, uitgerust met een "world action model"-architectuur, waarvan de algemene beschikbaarheid wordt aangekondigd voor eind 2026. Volgens NVIDIA slagen robots die dit uitvoeren voor nieuwe taken in onbekende omgevingen meer dan twee keer zo vaak als concurrerende vision-language-action-modellen.
Rond het model heen, een hele synthese-keten: de Physical AI Data Factory Blueprint, een open referentie-architectuur om trainingsdata op grote schaal te genereren, gebouwd op het Cosmos-wereldmodel en de OSMO-orchestrator; Isaac Lab 3.0 in early access, een reinforcement learning-motor gebaseerd op de Newton 1.0 fysica-motor en geoptimaliseerd voor DGX-infrastructuren. The Decoder vat de manoeuvre samen zonder genade: NVIDIA wil "het data-probleem van de robotica omzetten in een berekeningsprobleem".
De demonstratie die alles samenvat, is Olaf. Om deze robot te trainen, werden 100 000 virtuele instanties tegelijk gesimuleerd in twee dagen op een enkele NVIDIA RTX 4090 GPU, via de simulator Kamino — een proprietair tool van Disney Research, gebouwd op de Newton-solver en versneld door grafische kaarten. Daar zit het harde cijfer, opgegraven onder het folklore van de drie miljard humanoïden: niet een horizon in 2060, maar 100 000 instanties in twee dagen op een consumentenkaart. Op de dag dat het trainen van een robot stopt met het zijn van een probleem van armen en handschoenen en wordt tot een probleem van grafische kaarten, verlaat het zwaartepunt van de industrie de werkplaats voor het datacenter. En de consequentie is helder: als data wordt tot berekening, dan bezit degene die de berekening verkoopt de data per definitie.
Antwoord nr. 3: het decreteren
Op 12 maart keurt de Nationale Volksassemblee formeel het 15e Chinese Vijfjarenplan (2026-2030) goed. Voor het eerst wordt de geïncarneerde kunstmatige intelligentie erin geclassificeerd als een autonome strategische industriecategorie, op gelijke voet met quantum, brain-machine interfaces en 6G; humanoïde robots figureren onder de acht nationale strategische industrieën die zijn aangewezen, een verhoging van status ten opzichte van het 14e plan.
Het detail dat hier telt, is niet de algemene ambitie, maar de lijst. Het plan noemt vijf pijlers voor geïncarneerde AI, en twee daarvan noemen specifiek data als staatsinfrastructuur: de coördinatie van trainingsvelden en de virtueel-reële fusie voor samenwerkende training — dat wil zeggen de eerste twee antwoorden, verzamelen en synthetiseren, gepland van bovenaf. Het geheel gesteund door een staats venture capital-fonds van 1 000 miljard yuan (ongeveer 138 miljard dollar) gewijd aan AI, robotica en opkomende technologieën.
En om de data te laten bestaan, zijn er lichamen nodig die hem produceren. In maart tekent UBTech Robotics een strategisch samenwerkingsakkoord met Siemens Digital Industries Software om de productie van de Walker S2 op te schalen naar 10 000 eenheden per jaar, door de Siemens-software voor ontwerp, simulatie en planning te integreren in de hele fabricagecyclus. De machines massaal produceren die, eenmaal ingezet, op hun beurt de data zullen genereren: de lus sluit zich op staatsniveau.
De "geopolitieke bifurcatie" houdt niet stand
Het makkelijke verhaal van de week was dat van een scheur: een Europees tegenwicht — de RoboGym positioneert zich overigens expliciet tegenover de veertig Chinese verzamelcentra en de Amerikaanse initiatieven — tegenover rivaliserende blokken. De grafiek van de week ontmantelt dit verhaal.
De enige werkelijke autonomie die is aangetoond, zonder teleoperator, is op GTC: RealSense en LimX Dynamics realiseren de eerste wereldwijde demonstratie van autonome 3D-navigatie voor een humanoïde, door RealSense dieptecamera’s en NVIDIA cuVSLAM te combineren, waarbij de robot zich beweegt in gedeelde ruimtes met mensen zonder enige interventie van een operator. Maar deze robot is Chinees — LimX is gevestigd in Shenzhen — en hij is getraind door reinforcement learning in NVIDIA Isaac Lab om het sim-to-real-tekort te verkleinen.
Dezelfde week kondigen NEURA (Europa), Figure AI (Verenigde Staten), Agility Robotics (Verenigde Staten) en AgiBot (China) allemaal de adoptie aan van de Isaac GR00T N-modellen — terwijl NVIDIA de Newton-motor toevertrouwt aan de Linux Foundation en hem open source publiceert onder de Apache 2.0-licentie, samen ontwikkeld met Disney Research en Google DeepMind. De "kampen" strijden misschien om de data via geografie. Maar ze trainen allemaal op dezelfde simulator, met hetzelfde fundatiemodel, op dezelfde fysica-motor. De scheur zit in de verzameling, niet in het tool: op het niveau van de stack zijn er geen twee blokken, er is één leverancier.
Een verdieping lager
Deze draad daalt de stack af laag voor laag, week na week. In december was de demo het product; op CES in januari werd teleoperatie een data-business; in februari bleek het lichaam consumabel, de waarde zat in de hersenen; op 9 maart was de vraag: wie bezit de hersenen? Deze week daalt nog een stap verder, onder de hersenen: wie bezit de datafabriek die ze voedt? Het object is nieuw — de trainingsdata en zijn productiemodus — en het wordt dezelfde week bevestigd door een fysiek centrum (de RoboGym), een synthese-stack (de Data Factory en Olaf) en een staatsplan (het 15e Plan).
Dus vraag niet welke robot deze week het best heeft gelopen. Vraag waar zijn trainingsdata vandaan komt. De drie antwoorden — het handmatig verzamelen, het simuleren, het decreteren — tekenen de echte krachtenkaart. En terwijl de drie zich inspannen, werkt NVIDIA eraan dat er maar één vraag overblijft: hoeveel GPU’s?