
Utrwalimy tydzień od 10 do 16 marca 2026 roku jako tydzień humanoidów: ogromna sala treningowa w Monachium, keynote NVIDIA na GTC, chiński plan pięcioletni, robot-marionetka na scenie, prognoza trzech miliardów maszyn w 2060 roku. Sześć ogłoszeń, sześć gwiazd pierwszego składu i pokusa, by przyporządkować je do obozów — Europa przeciw Chinom, open source przeciw własnościowemu. To pominięcie jedynego zdania, które je łączy, a napisało je czarno na białym NEURA Robotics: głównym wąskim gardłem robotyki nie jest już sprzęt, lecz pozyskiwanie dużych ilości rzeczywistych danych do uczenia fizycznego.
Gdy to zdanie zostanie postawione, tydzień przestaje być jedynie zestawieniem. Staje się bitwą — z trzema niezgodnymi odpowiedziami — wokół jednego pytania: skąd pochodzą dane, które trenują roboty? Zbierać je ręcznie, syntetyzować przez obliczenia lub zadekretować przez państwo. Nikt nie wygrał. Walczyliśmy o to, kto posiada fabrykę.
Odpowiedź nr 1: zbieranie ręcznie
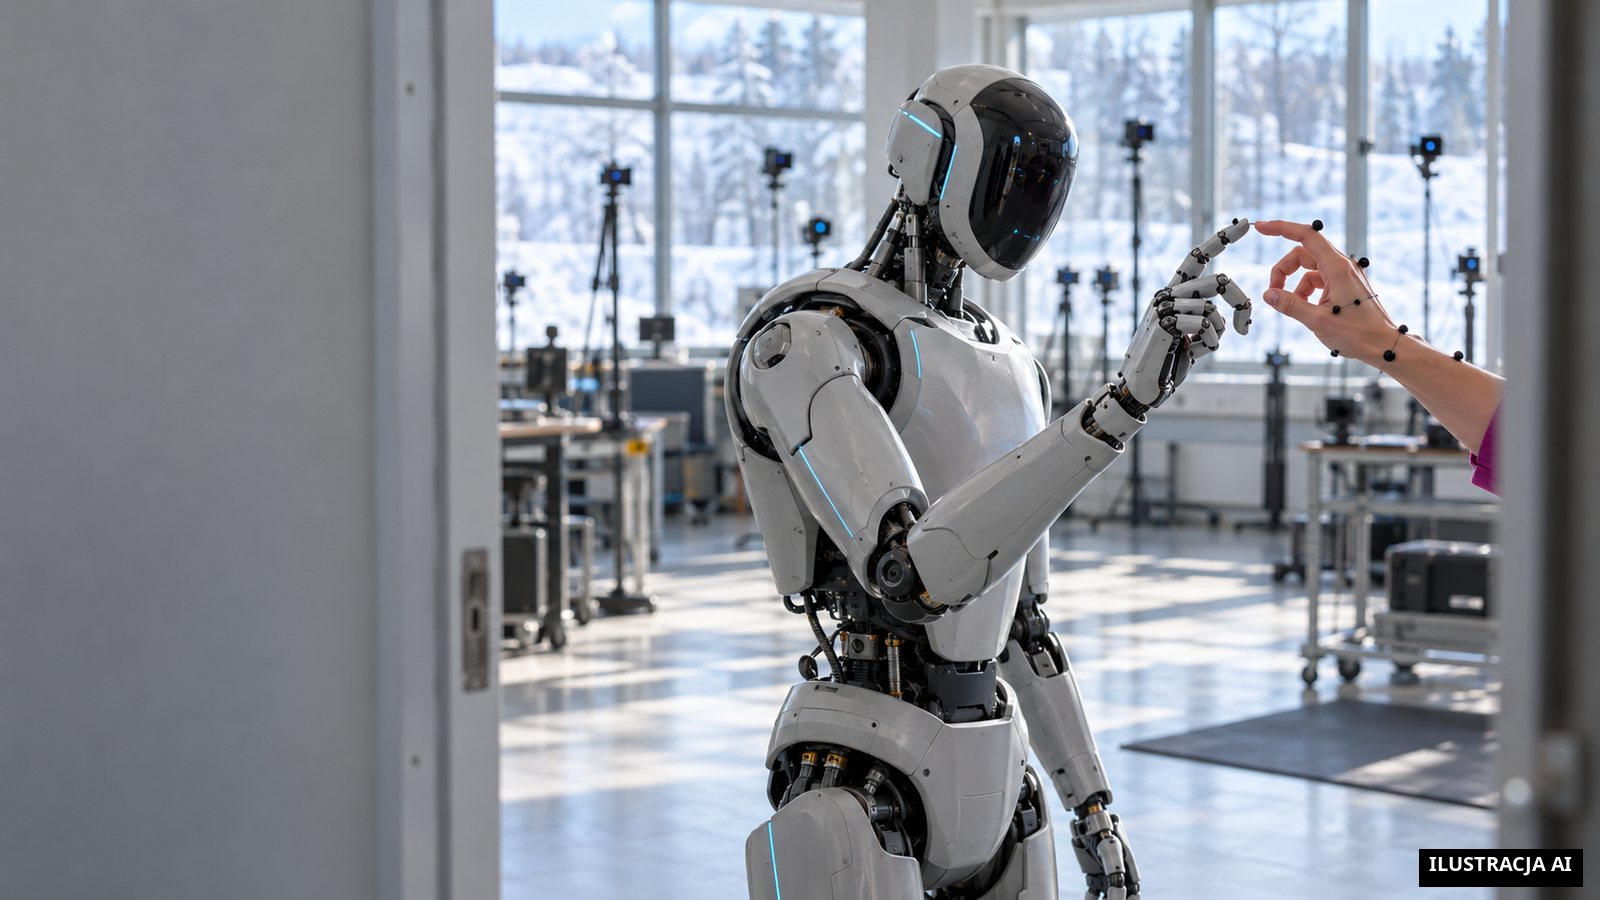
10 marca NEURA Robotics i MIRMI z Technischen Universität München wspólnie ogłaszają TUM RoboGym. Prezentacja jest bez owijania w bawełnę: największe centrum naukowe w Europie poświęcone treningowi Physical AI w momencie ogłoszenia. Ale wewnętrzne urządzenie mówi lepiej niż superlatywy, o co chodzi. Dane do uczenia są tam pozyskiwane przez trenerów ludzkich noszących rękawice MANUS i system przechwytywania ruchu ciała Xsens, a następnie wstrzykiwane w platformę Neuraverse.
To dosłowne przyznanie się do wąskiego gardła: płaci się ludziom, aby ręcznie wytwarzali brakujący surowiec. Neuraverse jest zresztą zaprojektowany jako agnostyczny względem sprzętu system zbierania i dystrybucji, przeznaczony do otwarcia się na partnerów przemysłowych i startupy, a większość danych generowanych w RoboGym zostanie udostępniona w otwartym kodzie społeczności robotycznej. Ruch ludzki, przechwycony i redystrybuowany, jako zasób. Dane nie są produktem ubocznym treningu: one są produktem, a do ich wytworzenia potrzeba hali o wartości 17 milionów euro.
Odpowiedź nr 2: syntetyzowanie przez obliczenia
Na GTC 2026, 16 marca, NVIDIA dokonuje dokładnie odwrotnej operacji — i przyjmuje ją. Jensen Huang premierowo ujawnia GR00T N2, model bazowy robotyczny wynikający z wewnętrznych badań DreamZero, wyposażony w architekturę „world action model”, którego ogólna dostępność jest zapowiedziana na koniec 2026 roku. Według NVIDIA, roboty wykonujące ten model wykonują nowe zadania w nieznanych środowiskach ponad dwa razy częściej niż konkurencyjne modele wizja-język-działanie.
Wokół modelu cała łańcuch syntez: Physical AI Data Factory Blueprint, otwarta referencyjna architektura do generowania danych treningowych na dużą skalę, oparta na modelu świata Cosmos i orkiestratorze OSMO; Isaac Lab 3.0 w wczesnym dostępie, silnik uczenia przez wzmacnianie oparty na silniku fizycznym Newton 1.0 i zoptymalizowany pod infrastrukturę DGX. The Decoder podsumowuje manewr bez ogródek: NVIDIA chce „przekształcić problem danych w robotyce w problem obliczeniowy”.
Demonstracja, która skondensowuje wszystko, to Olaf. Aby wytrenować tego robota, 100 000 instancji wirtualnych zostało zasymulowanych jednocześnie w ciągu dwóch dni na pojedynczej karcie graficznej NVIDIA RTX 4090, za pośrednictwem symulatora Kamino — narzędzia własnego Disney Research, opartego na solverze Newton i przyspieszanego przez kartę graficzną. Tu jest twarda liczba, wykopana spod folkloru trzech miliardów humanoidów: nie horyzont 2060, ale 100 000 instancji w dwa dni na karcie dla konsumentów. Dzień, w którym trenowanie robota przestaje być problemem ramion i rękawic, a staje się problemem kart graficznych, środek ciężkości branży opuszcza warsztat i przenosi się do centrum danych. A konsekwencja jest jasna: jeśli dane stają się obliczeniami, ten, kto sprzedaje obliczenia, domyślnie posiada dane.
Odpowiedź nr 3: zadekretowanie
12 marca Zgromadzenie Narodowe Ludowe formalnie przyjmuje 15. chiński plan pięcioletni (2026-2030). Po raz pierwszy wcielena sztuczna inteligencja jest tam klasyfikowana jako samodzielna strategiczna kategoria przemysłowa, na równi z kwantową, interfejsami mózg-maszyna i 6G; roboty-humanoidy znajdują się wśród ośmiu wyznaczonych krajowych strategicznych branż, co jest podwyższeniem statusu w porównaniu z 14. planem.
Szczegół, który tu ma znaczenie, to nie ogólna ambicja, ale lista. Plan wymienia pięć kierunków dla wcieloną AI, a dwa z nich precyzyjnie nazywają dane jako infrastrukturę państwową: koordynacja terenów treningowych i fuzja wirtualno-rzeczywistego dla treningu kooperacyjnego — czyli dwie pierwsze odpowiedzi, zbieranie i synteza, planowane od góry. Całość oparta na funduszu venture capital państwowym o wartości 1 000 miliardów juanów (około 138 miliardów dolarów) przeznaczonym na AI, robotykę i technologie wschodzące.
A aby dane istniały, potrzebne są ciała, które je produkują. W marcu UBTech Robotics podpisuje umowę o współpracy strategicznej z Siemens Digital Industries Software, aby zwiększyć produkcję Walker S2 do 10 000 jednostek rocznie, integrując oprogramowanie Siemens do projektowania, symulacji i planowania w całym cyklu produkcji. Masowa produkcja maszyn, które, po wdrożeniu, z kolei wygenerują dane: pętla zamyka się w skali państwa.
„Geopolityczna bifurkacja” się nie trzyma
Łatwa narracja tego tygodnia była opowieścią o pęknięciu: europejski przeciwwaga — RoboGym pozycjonuje się zresztą wyraźnie wobec czterdziestu chińskich centrów zbierania i inicjatyw amerykańskich — przeciw rywalizującym blokom. Graf tego tygodnia demontuje tę narrację.
Jedynym udowodnionym rzeczywistym autonomicznym osiągnięciem, bez teleoperatora, jest to na GTC: RealSense i LimX Dynamics realizują pierwszą na świecie demonstrację autonomicznej nawigacji 3D dla humanoida, łącząc kamery głębi RealSense i cuVSLAM od NVIDIA, przy czym robot porusza się w przestrzeniach współdzielonych z ludźmi bez żadnej interwencji operatora. A ten robot jest chiński — LimX ma siedzibę w Shenzhen — i został wytrenowany przez uczenie przez wzmacnianie w NVIDIA Isaac Lab, aby zmniejszyć rozbieżność sim-to-real.
W tym samym tygodniu NEURA (Europa), Figure AI (Stany Zjednoczone), Agility Robotics (Stany Zjednoczone) i AgiBot (Chiny) wszyscy ogłaszają przyjęcie modeli Isaac GR00T N — podczas gdy NVIDIA powierza silnik Newton Linux Foundation i publikuje go w otwartym kodzie na licencji Apache 2.0, współtworzony z Disney Research i Google DeepMind. „Obozy” mogą walczyć o dane przez geografię. Ale trenują je wszystkie na tym samym symulatorze, z tym samym modelem bazowym, na tym samym silniku fizycznym. Pęknięcie jest w zbieraniu, nie w narzędziu: na poziomie stosu nie ma dwóch bloków, jest jeden dostawca.
Stopień niżej
Ten wątek schodzi po stosie warstwa po warstwie, tydzień po tygodniu. W grudniu demo było produktem; na CES w styczniu teleoperacja stawała się biznesem danych; w lutym ciało okazało się konsumowalne, wartość mieszkała w mózgu; 9 marca pytanie brzmiało: kto posiada mózg? Ten tydzień schodzi o stopień niżej, pod mózg: kto posiada fabrykę danych, która go karmi? Przedmiot jest nowy — dane treningowe i ich sposób produkcji — i jest potwierdzony w tym samym tygodniu przez centrum fizyczne (RoboGym), stos syntezy (Data Factory i Olaf) i plan państwowy (15. Plan).
Zatem nie pytajcie, który robot najlepiej chodził w tym tygodniu. Zapytajcie, skąd pochodzą jego dane treningowe. Trzy odpowiedzi — zbieranie ręcznie, symulowanie, zadekretowanie — rysują prawdziwą mapę sił. A podczas gdy trzy się starają, NVIDIA pracuje nad tym, aby pozostało tylko jedno pytanie do zadania: ile GPU?