
Die Woche vom 10. bis 16. März 2026 wird als die Woche der Humanoiden in Erinnerung bleiben: eine riesige Trainingshalle in München, ein NVIDIA-Keynote auf dem GTC, ein chinesischer Fünfjahresplan, ein Puppenroboter auf der Bühne, eine Prognose von drei Milliarden Maschinen im Jahr 2060. Sechs Ankündigungen, sechs Hauptdarsteller und die Versuchung, sie in Lager einzuordnen – Europa gegen China, Open Source gegen proprietär. Das verfehlt den einzigen Satz, der sie verbindet, und es ist NEURA Robotics, der ihn schwarz auf weiß geschrieben hat: Die wichtigste Engstelle der Robotik ist nicht mehr die Hardware, sondern die Erfassung großer Mengen echter physischer Lerndaten.
Sobald dieser Satz steht, hört die Woche auf, eine bloße Aneinanderreihung zu sein. Sie wird zu einem Kampf – mit drei unvereinbaren Antworten – um eine einzige Frage: Woher kommen die Daten, die die Roboter trainieren? Sie von Hand einsammeln, sie durch Berechnung synthetisieren oder sie durch den Staat verordnen. Niemand hat gewonnen. Man hat darum gekämpft, wer die Fabrik besitzt.
Antwort Nr. 1: Sie von Hand einsammeln
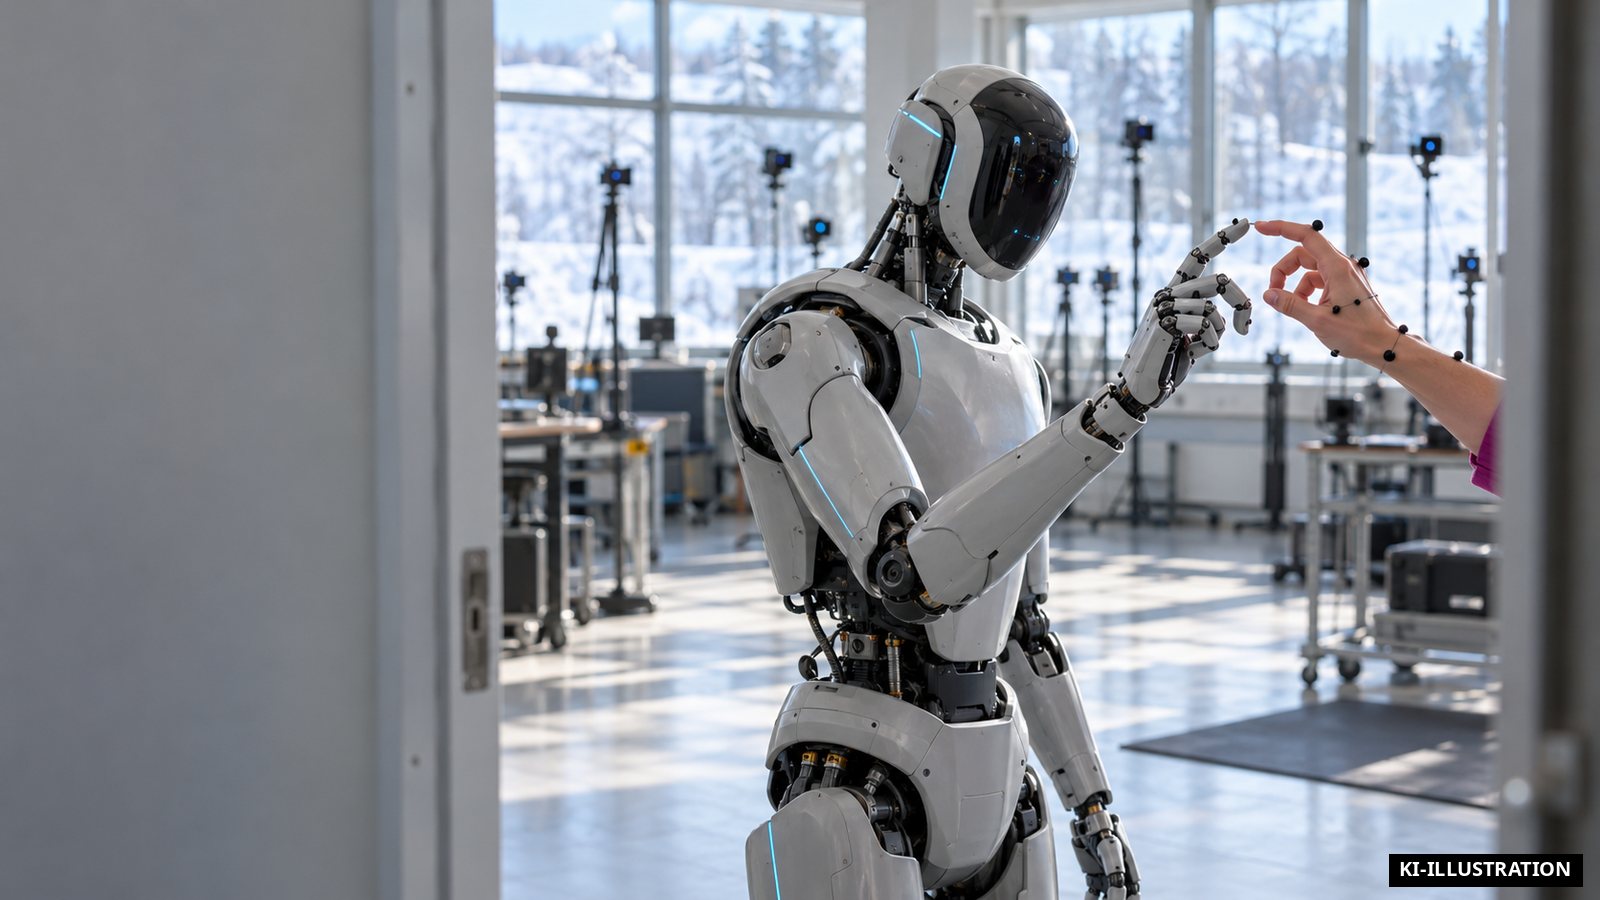
Am 10. März kündigen NEURA Robotics und das MIRMI der Technischen Universität München gemeinsam das TUM RoboGym an. Die Präsentation ist unmissverständlich: Das größte wissenschaftliche Zentrum Europas, das dem Training von Physical AI gewidmet ist, zum Zeitpunkt seiner Ankündigung. Aber die innere Einrichtung sagt besser als Superlative, worum es geht. Die Lerndaten werden dort von menschlichen Trainern erfasst, die MANUS-Handschuhe und ein Xsens-Bewegungserfassungssystem tragen, und dann in die Plattform Neuraverse eingespeist.
Das ist das wörtliche Eingeständnis der Engstelle: Man bezahlt Menschen, um das fehlende Rohmaterial von Hand herzustellen. Neuraverse ist zudem als hardware-agnostisches System zur Erfassung und Verteilung konzipiert, das für Industriepartner und Startups geöffnet werden soll, und die Mehrheit der im RoboGym generierten Daten wird als Open Source mit der Robotik-Community geteilt. Die menschliche Bewegung, erfasst und weiterverteilt, als Ressource. Die Daten sind kein Nebenprodukt des Trainings: Sie sind das Produkt, und es braucht eine Halle im Wert von 17 Millionen Euro, um sie zu produzieren.
Antwort Nr. 2: Sie durch Berechnung synthetisieren
Auf dem GTC 2026, am 16. März, vollzieht NVIDIA genau das Gegenteil – und bekennt sich dazu. Jensen Huang enthüllt im Vorfeld GR00T N2, ein robotisches Foundation-Modell aus der internen Forschung DreamZero, ausgestattet mit einer „world action model“-Architektur, dessen allgemeine Verfügbarkeit für Ende 2026 angekündigt wird. Laut NVIDIA erreichen Roboter, die es ausführen, neue Aufgaben in unbekannten Umgebungen mehr als doppelt so oft wie konkurrierende Vision-Language-Action-Modelle.
Rund um das Modell eine ganze Kette der Synthese: das Physical AI Data Factory Blueprint, eine offene Referenzarchitektur zur Generierung von Trainingsdaten im großen Maßstab, aufgebaut auf dem Weltmodell Cosmos und dem Orchestrierer OSMO; Isaac Lab 3.0 im Early Access, ein Reinforcement-Learning-Engine, der auf der Physik-Engine Newton 1.0 basiert und für DGX-Infrastrukturen optimiert ist. The Decoder fasst den Schachzug ohne Umschweife zusammen: NVIDIA will „das Datenproblem der Robotik in ein Berechnungsproblem verwandeln“.
Die Demonstration, die alles zusammenfasst, ist Olaf. Um diesen Roboter zu trainieren, wurden 100 000 virtuelle Instanzen gleichzeitig in zwei Tagen auf einer einzigen NVIDIA RTX 4090-GPU simuliert, über den Simulator Kamino – ein proprietäres Tool von Disney Research, aufgebaut auf dem Newton-Solver und durch Grafikkarten beschleunigt. Hier liegt die harte Zahl, ausgegraben unter dem Folklore der drei Milliarden Humanoiden: nicht ein Horizont im Jahr 2060, sondern 100 000 Instanzen in zwei Tagen auf einer Consumer-Karte. An dem Tag, an dem das Training eines Roboters aufhört, ein Problem von Armen und Handschuhen zu sein, und zu einem Problem von Grafikkarten wird, verlässt der Schwerpunkt der Industrie die Werkstatt und zieht ins Rechenzentrum. Und die Konsequenz ist klar: Wenn die Daten zu Berechnung werden, besitzt derjenige, der die Berechnung verkauft, die Daten per Default.
Antwort Nr. 3: Sie verordnen
Am 12. März billigt die Nationale Volksversammlung formell den 15. chinesischen Fünfjahresplan (2026-2030). Zum ersten Mal wird die verkörperte künstliche Intelligenz darin als eigenständige strategische Industriekategorie eingestuft, auf gleicher Ebene wie Quanten, Gehirn-Maschinen-Schnittstellen und 6G; Humanoid-Roboter sind unter den acht benannten nationalen strategischen Industrien, eine Aufwertung im Vergleich zum 14. Plan.
Das Detail, das hier zählt, ist nicht die allgemeine Ambition, sondern die Liste. Der Plan enumeriert fünf Achsen für die verkörperte KI, und zwei davon benennen die Daten explizit als staatliche Infrastruktur: die Koordination der Trainingsplätze und die virtuell-reale Fusion für kollaboratives Training – das heißt die ersten beiden Antworten, Einsammlung und Synthese, von oben geplant. Das Ganze gestützt auf einen staatlichen Venture-Capital-Fonds von 1 000 Milliarden Yuan (etwa 138 Milliarden US-Dollar), der der KI, der Robotik und aufkommenden Technologien gewidmet ist.
Und damit die Daten existieren, braucht es Körper, die sie produzieren. Im März unterzeichnet UBTech Robotics eine strategische Kooperationsvereinbarung mit Siemens Digital Industries Software, um die Produktion des Walker S2 auf 10 000 Einheiten pro Jahr zu steigern, indem die Siemens-Software für Konzeption, Simulation und Planung in den gesamten Fertigungszyklus integriert wird. Die Maschinen in Massen herstellen, die, einmal deployed, ihrerseits die Daten generieren: Der Kreis schließt sich auf Staatsebene.
Die „geopolitische Bifurkation“ hält nicht stand
Die einfache Erzählung der Woche war die einer Spaltung: ein europäisches Gegengewicht – das RoboGym positioniert sich explizit gegenüber den vierzig chinesischen Erfassungszentren und den amerikanischen Initiativen – gegen rivalisierende Blöcke. Der Graph der Woche demontiert diese Erzählung.
Die einzige echte Autonomie, die ohne Teleoperator demonstriert wurde, war auf dem GTC: RealSense und LimX Dynamics vollziehen die erste weltweite Demonstration der autonomen 3D-Navigation für Humanoiden, indem sie RealSense-Tiefenkameras und NVIDIA cuVSLAM kombinieren, wobei der Roboter in Räumen, die mit Menschen geteilt werden, agiert, ohne jegliche Intervention eines Operators. Doch dieser Roboter ist chinesisch – LimX hat seinen Sitz in Shenzhen – und er wurde durch Reinforcement Learning in NVIDIA Isaac Lab trainiert, um die Sim-to-Real-Lücke zu verringern.
Dieselbe Woche kündigen NEURA (Europa), Figure AI (Vereinigte Staaten), Agility Robotics (Vereinigte Staaten) und AgiBot (China) alle die Adoption der Isaac GR00T N-Modelle an – während NVIDIA die Newton-Engine der Linux Foundation anvertraut und sie unter der Apache 2.0-Lizenz als Open Source veröffentlicht, gemeinsam entwickelt mit Disney Research und Google DeepMind. Die „Lager“ streiten sich vielleicht über die Daten durch die Geographie. Aber sie trainieren sie alle auf demselben Simulator, mit demselben Foundation-Modell, auf derselben Physik-Engine. Die Spaltung liegt in der Erfassung, nicht im Werkzeug: Auf Stack-Ebene gibt es nicht zwei Blöcke, es gibt einen Lieferanten.
Ein Stockwerk tiefer
Diese Fäden steigen den Stack Schicht für Schicht, Woche für Woche hinab. Im Dezember war die Demo das Produkt; auf dem CES im Januar wurde die Teleoperation zu einem Datenbusiness; im Februar zeigte sich der Körper als konsumierbar, der Wert lag im Gehirn; am 9. März war die Frage: Wer besitzt das Gehirn? Diese Woche steigt einen Schritt weiter hinab, unter das Gehirn: Wer besitzt die Datenfabrik, die es ernährt? Das Objekt ist neu – die Trainingsdaten und ihre Produktionsweise – und es wird in derselben Woche durch ein physisches Zentrum (das RoboGym), einen Synthese-Stack (die Data Factory und Olaf) und einen Staatsplan (der 15. Plan) bezeugt.
Dann fragt nicht, welcher Roboter diese Woche am besten gelaufen ist. Fragt, woher seine Trainingsdaten kommen. Die drei Antworten – sie von Hand einsammeln, sie simulieren, sie verordnen – zeichnen die wahre Karte der Kräfte. Und während die drei sich abmühen, arbeitet NVIDIA daran, dass es nur noch eine einzige Frage gibt: Wie viele GPU?